MindTopo يختبر الفرق بين فهم الصورة والتخطيط للحركة لدى الذكاء الاصطناعي
قدمت Microsoft Research المعيار في 12 أغسطس. يركز التقرير على قدرة النماذج على تتبع العلاقات المكانية عندما تتحول الإجابة إلى سلسلة من الأفعال.

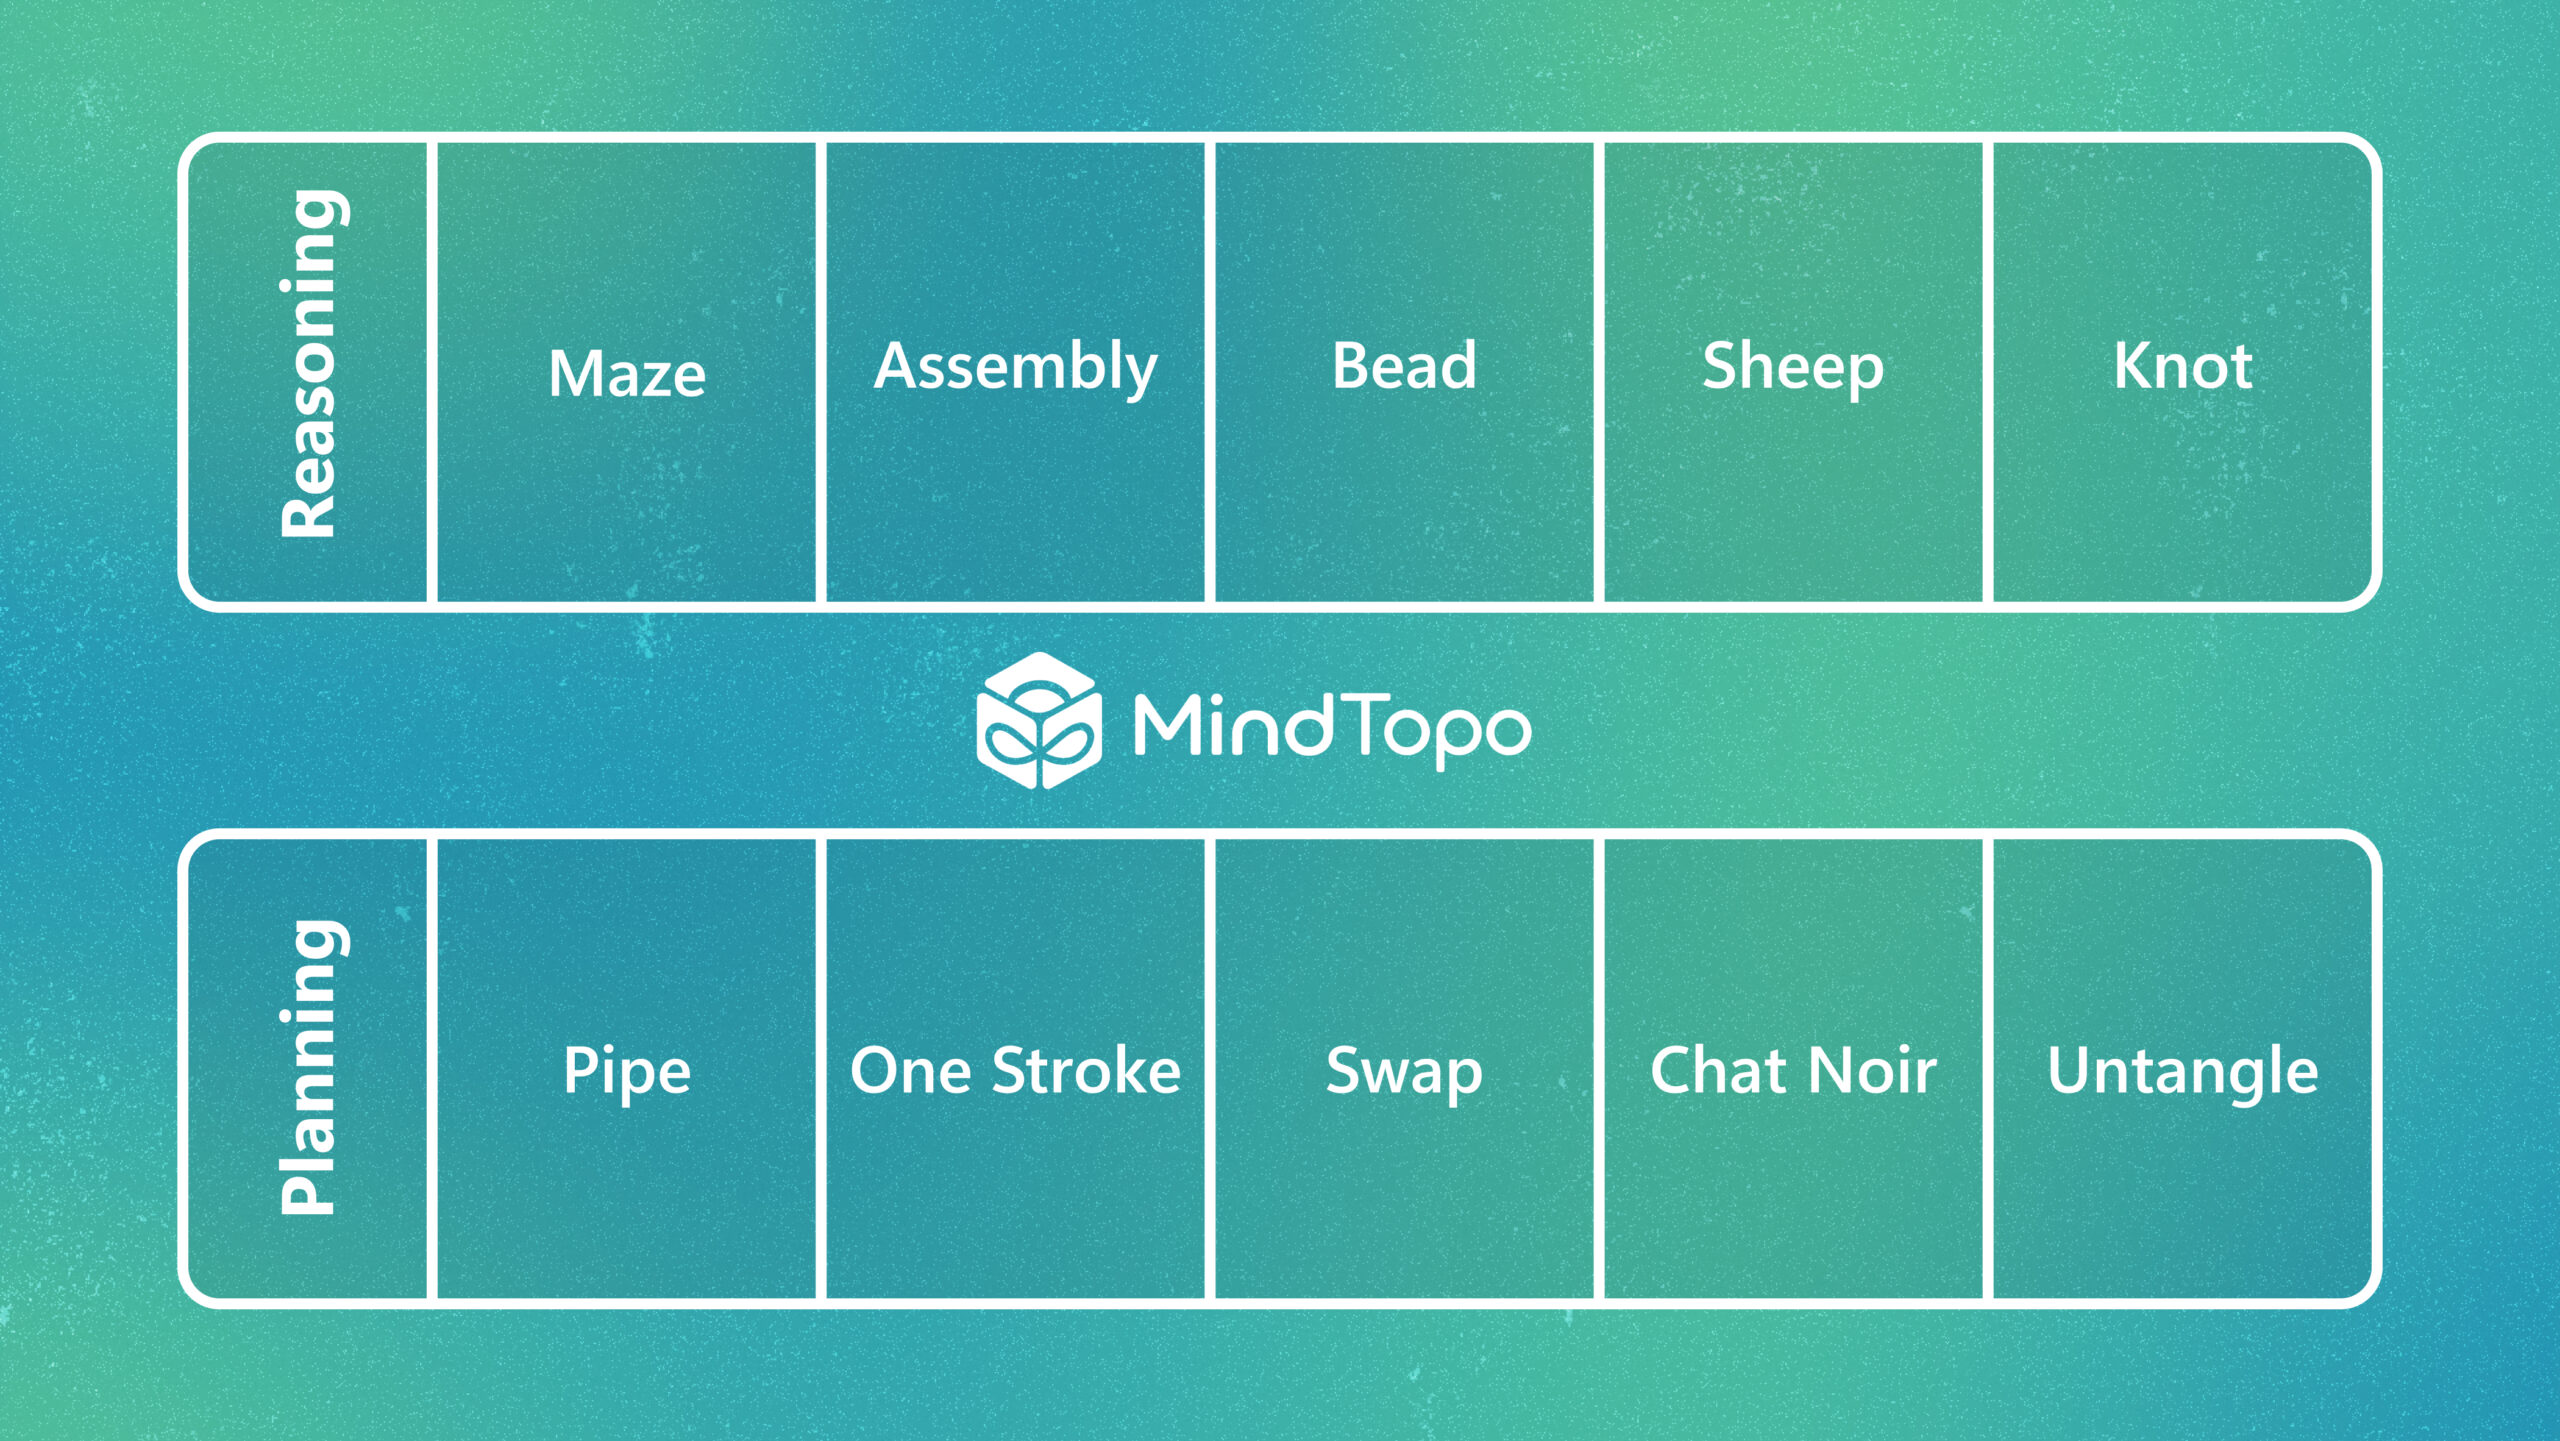
قدمت Microsoft Research في 12 أغسطس 2026 معيار MindTopo لتقييم فهم نماذج الرؤية واللغة للعلاقات المكانية. وفي تقريرنا بتاريخ 13 أغسطس، ننظر إلى سؤال أساسي: هل يستطيع النموذج الحفاظ على هذه العلاقات عندما ينتقل من وصف المشهد إلى التصرف داخله؟
السؤال يتجاوز مكان الجسم
لا يقتصر الاستدلال الطوبولوجي على قياس المسافة أو الزاوية. فهو يسأل مثلًا: هل يبقى المسار متصلًا؟ هل الجسم داخل حدود أم خارجها؟ وهل توجد عقدة فعلية أم مجرد تشابك ظاهري؟
ينظم MindTopo ثلاثة عشر نوعًا من المهام حول الاستمرارية والانفصال والترتيب والاحتواء والعقد. ويجمع بين أسئلة عن صور ثابتة ومهام تخطيط تتطلب سلسلة أفعال في بيئات اختبار.
وهذا التنظيم يساعد على الفصل بين وصف علاقة موجودة واتخاذ قرار يحافظ عليها أو يغيرها. قد تبدو النتيجة النهائية بسيطة للقارئ، بينما يعتمد الوصول إليها على تتبع ما يتغير بعد كل خطوة.
التعرف والتخطيط ليسا اختبارًا واحدًا
يقول الباحثون إن النماذج أدت بصورة أفضل في الاستدلال على المشاهد الثابتة مقارنة بالتخطيط التفاعلي. وظهرت بعض الإخفاقات بعد فهم المشهد، عندما احتاج النموذج إلى تتبع العلاقات عبر عدة أفعال.
للتوضيح، هناك فرق بين الإجابة بأن ممرًا مفتوح، واختيار حركة تُبقيه مفتوحًا بعد نقل أحد العناصر. السؤال الثاني يتطلب النظر إلى أثر الفعل، وليس الاكتفاء بالتعرف على الحالة الحالية. هذا مثال توضيحي، وليس تجربة أجريناها.
وتصبح هذه الفروق مهمة عند تقييم المساعدين الذين ينفذون خطوات. فقد تكون إجابة منفردة صحيحة، بينما تحتاج موثوقية العملية الكاملة إلى فحص كل انتقال بين حالة وأخرى.
ماذا يمكن استنتاجه للروبوتات؟
تلفت الدراسة الانتباه إلى نوع من الفهم له صلة بالتفاعل مع البيئات. لكن MindTopo لا يقدم حكمًا شاملًا على جميع قدرات الذكاء الاصطناعي أو جميع الروبوتات؛ إنه يقيس مهام محددة في بيئات مضبوطة.
ولذلك يتطلب نقل النتيجة إلى تطبيق واقعي اختبارات تناسب ذلك التطبيق. فالنجاح أو الإخفاق في معيار واحد لا يصف تلقائيًا الأداء في كل بيئة أو مهمة.
من وجهة نظرنا، تكمن قيمة هذا النوع من الأبحاث في تحديد موضع الخطأ: هل المشكلة في قراءة المشهد، أم في حفظ العلاقة، أم في اختيار الخطوة التالية؟ الإجابة عن هذه الأسئلة تقدم للمطورين معلومات أوضح من رقم إجمالي منفرد.
المصادر
مؤسس ورئيس تحرير Kurd Developers. أخبار الهواتف والتقنية على YouTube وInstagram وTikTok.
مقالات أخرى
Apple Intelligence تصل إلى الصين مع iOS 27.3 بدعم من Alibaba
بعد أكثر من عامين من الانتظار، أعلنت Apple أن ميزات Apple Intelligence ستصل إلى مستخدمي iPhone في الصين خلال ديسمبر، مع دمج نموذج Qwen من Alibaba في Siri.

رسالة واحدة قد تعطّل هاتفك: ثغرة SMS of Death في أندرويد
ثغرة في Android 12 وما بعده تقطع المكالمات عبر رسالة SMS خاصة وقد تجعل الهاتف غير صالح للاستخدام. الإصلاح موجود في تحديث أكتوبر الأمني.

GTA VI تصل في 19 نوفمبر: الأسعار والإصدارات وكل ما تحتاج معرفته
أكدت Rockstar الموعد: الخميس 19 نوفمبر على PS5 و Xbox Series X|S. الإصدار العادي بـ 79.99 دولاراً و Ultimate بـ 99.99 دولاراً.

آبل تكشف عن أول MacBook Pro بشاشة لمس و Dynamic Island
شاشة PROLED XDR الجديدة تعمل باللمس، والنوتش اختفى ليحلّ محله Dynamic Island. السعر يبدأ من 2,899 دولاراً.